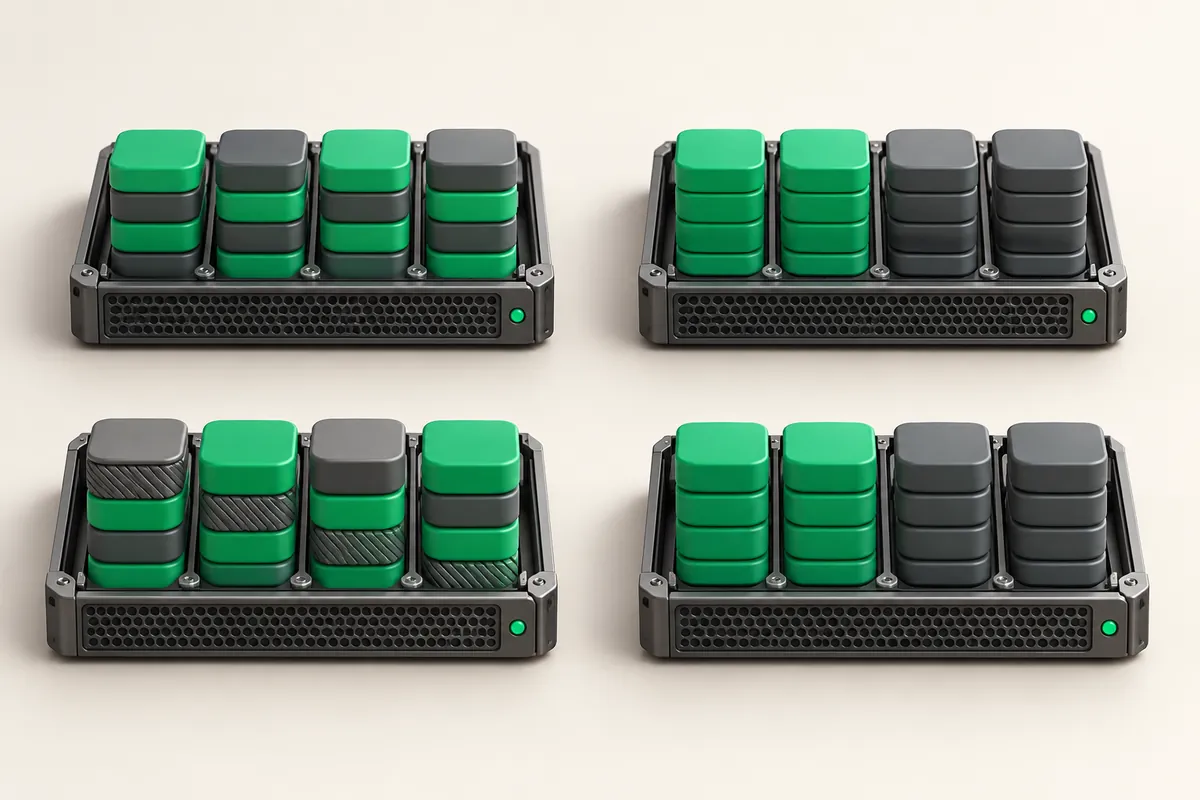
RAID 0, 1, 5, 10: какой уровень выбрать для сервера
Под системный том и большинство рабочих задач берите RAID 1 из двух дисков. Под нагруженную базу данных и виртуализацию — RAID 10 из четырёх и более накопителей. Под файловое хранилище, где решает объём, — RAID 5 или RAID 6. RAID 0 в продакшене не используют: он ничего не резервирует и удваивает шанс потерять данные.
- RAID 1 — зеркало: полезна ёмкость одного диска, массив переживает отказ одного из двух.
- RAID 10 — зеркальные пары, объединённые в страйп: 50% ёмкости, лучшая случайная запись, быстрое восстановление копированием.
- RAID 5 — чётность: полезны N−1 дисков, но каждая случайная запись стоит четырёх операций, а ребилд идёт часами.
- RAID 6 переживает отказ двух дисков и нужен на массивах от шести накопителей.
- Ни один уровень не заменяет бэкап: удаление файла и шифровальщик отражаются на всех дисках сразу.
Что RAID решает, а что нет
RAID объединяет несколько физических накопителей в один логический том. Уровень описывает способ раскладки данных: копирование (зеркало), нарезку на полосы (страйп) или вычисление контрольной суммы (чётность).
Отказоустойчивые уровни закрывают ровно один сценарий — внезапную смерть накопителя или лавинообразный рост числа сбойных секторов. Логические ошибки массив не ловит: неудачная миграция, rm -rf не в том каталоге и шифровальщик попадают на все диски одновременно. Поэтому массив и резервное копирование сервера решают разные задачи, и нужны оба.
RAID 0: скорость без страховки
Данные режутся на полосы и пишутся на все диски параллельно. Линейная скорость и IOPS растут почти пропорционально числу накопителей, полезная ёмкость равна сумме. Избыточности нет совсем: массив из двух дисков умирает примерно вдвое чаще одиночного диска, из четырёх — вчетверо.
Уровень оправдан там, где данные восстанавливаются за минуты и без вашего участия: кэш перекодированного видео, каталог сборки CI, реплика для чтения, которая переналивается с мастера.
RAID 1: зеркало на два диска
Каждый блок пишется на оба накопителя. Полезная ёмкость равна объёму одного диска, то есть половине сырого объёма. Чтение раздаётся с обеих половин, запись идёт со скоростью медленной из них.
Это стандарт для загрузочного тома и для серверов, чьи данные помещаются на один накопитель. Тарифы Dedicated Start и Dedicated Pro на выделенных серверах ZevsHost собраны именно так: 2×500 GB SSD или 2×1 TB NVMe в RAID 1.
RAID 5 и RAID 6: чётность вместо копии
RAID 5 хранит один блок чётности на каждую полосу и распределяет его по всем дискам. Из N накопителей полезны N−1: из шести дисков по 1 TB выходит 5 TB. Чтение быстрое, а запись платит штраф — изменение одного блока превращается в два чтения и две записи.
RAID 6 держит два блока чётности, переживает отказ двух дисков подряд, отдаёт полезными N−2 накопителя и платит уже шестью операциями на случайную запись.
RAID 10: зеркала в страйпе
Диски разбиваются на зеркальные пары, а пары объединяются в страйп. Полезны 50% сырой ёмкости, минимум четыре накопителя. На случайной записи RAID 10 обгоняет RAID 5 в 4–6 раз: блок просто ложится на два диска пары, чётность пересчитывать не нужно.
Ребилд тоже дешевле — система копирует содержимое уцелевшей половины пары, а не пересобирает данные со всего массива. Конфигурация Dedicated Enterprise US с 4×1 TB NVMe собрана в RAID 10 как раз под базы данных и гипервизор.
Сравнение уровней
| Уровень | Мин. дисков | Полезная ёмкость | Переживает отказ | Штраф на запись | Типовая задача |
|---|---|---|---|---|---|
| RAID 0 | 2 | 100% | 0 дисков | нет | кэш, временные данные |
| RAID 1 | 2 | 50% | 1 диск | нет | системный том, веб-сервер |
| RAID 5 | 3 | (N−1)/N | 1 диск | 4 операции | архив, файловое хранилище |
| RAID 6 | 4 | (N−2)/N | 2 диска | 6 операций | широкий массив на HDD |
| RAID 10 | 4 | 50% | 1 диск в каждой паре | нет | СУБД, виртуализация |
Сборка и проверка массива
Программный массив собирается парой команд. Выбор реализации — контроллер или mdadm — разобран в статье аппаратный RAID или mdadm; здесь только минимум, чтобы увидеть уровень и состояние.
# Debian/Ubuntu
apt-get install -y mdadm
# RHEL, AlmaLinux, Rocky
dnf install -y mdadm

# зеркало из двух разделов
mdadm --create /dev/md0 --level=1 --raid-devices=2 /dev/nvme0n1p2 /dev/nvme1n1p2

# RAID 10 из четырёх дисков
mdadm --create /dev/md1 --level=10 --raid-devices=4 /dev/sda1 /dev/sdb1 /dev/sdc1 /dev/sdd1

# текущее состояние всех массивов
cat /proc/mdstat
mdadm --detail /dev/md0 2>&1 | grep -E 'Raid Level|State|Failed|Active'
Массив в состоянии degraded продолжает работать и ничем себя не выдаёт: сайт открывается, база отвечает, нагрузка обычная. Отказ второго диска в RAID 1 или RAID 5 в этот момент уничтожает данные целиком, восстанавливать будет нечего. Заведите проверку сразу после сборки: cat /proc/mdstat должен показывать все устройства буквой U в скобках, например [UU], а mdadm --detail — строки State : clean и Failed Devices : 0. Символ подчёркивания вместо U означает выпавший накопитель и требует замены диска в тот же день.
Коротко
- Системный том и типовой веб-сервер — RAID 1 из двух дисков.
- База данных, гипервизор, активная случайная запись — RAID 10 от четырёх накопителей.
- Архив на больших HDD — RAID 6; RAID 5 допустим только на узких массивах до пяти дисков.
- RAID 0 — исключительно под данные, потеря которых не создаёт инцидента.
- Любой уровень требует отдельных бэкапов и мониторинга состояния массива.