
Proxmox VE предоставляет встроенный инструмент vzdump для резервного копирования VM и LXC-контейнеров. Расписание настраивается через веб-интерфейс или CLI и поддерживает гибкие политики хранения (retention).
Режимы бэкапа
| Режим | Описание | Влияние на VM | Когда использовать |
|---|---|---|---|
| snapshot | Снапшот + бэкап на ходу | Нет остановки | Продакшн VM (KVM) |
| suspend | Заморозка, бэкап, возобновление | Кратковременная пауза | Консистентный бэкап |
| stop | Остановка, бэкап, запуск | Полная остановка | Самый надёжный вариант |
Настройка расписания через веб-интерфейс
Перейдите в Datacenter → Backup → Add:
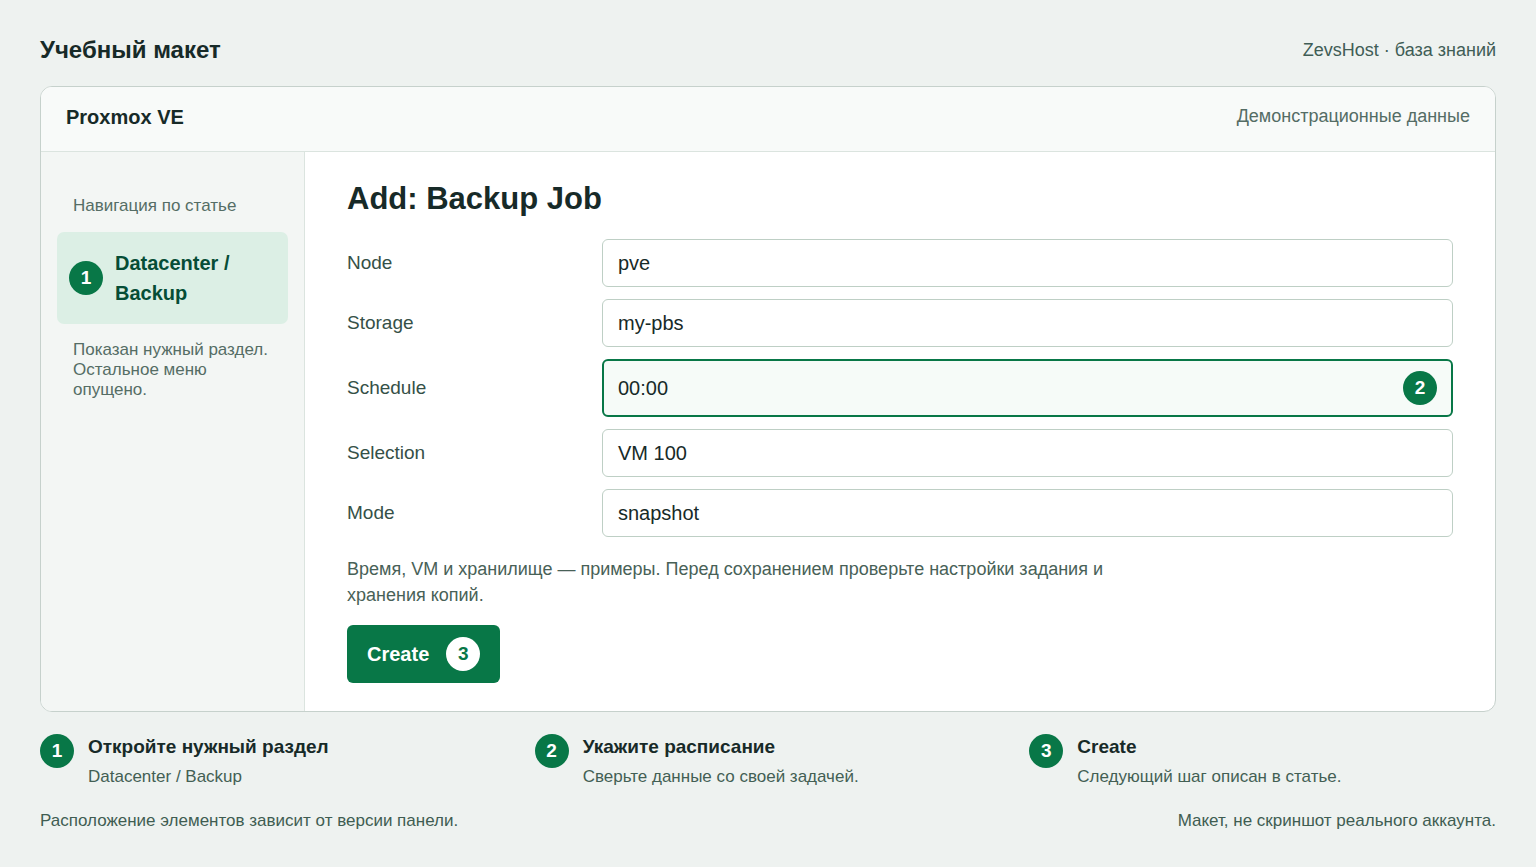
- Node: выбрать ноду или All
- Storage: указать PBS или локальное хранилище
- Schedule: выбрать время (например,
00:00для ночного бэкапа) - Selection: All, Pool, или конкретные VM
- Mode: snapshot / suspend / stop
- Retention: количество бэкапов для хранения
Настройка через CLI (vzdump)
# Ручной бэкап VM 100 в PBS
vzdump 100   --storage my-pbs   --mode snapshot   --compress zstd   --notes-template "{{guestname}} - {{node}}"

# Бэкап всех VM на ноде
vzdump --all 1 --storage my-pbs --mode snapshot

# Бэкап в локальный файл
vzdump 100 --dumpdir /mnt/backup --mode stop
Retention Policy (политика хранения)
PBS поддерживает гибкое управление количеством хранимых бэкапов:
# Примеры retention в /etc/vzdump.conf или настройках задания
# 7 ежедневных + 4 еженедельных + 3 ежемесячных
keep-daily 7
keep-weekly 4
keep-monthly 3

# Через API
pvesh set /cluster/backup/1   --keep-daily 7   --keep-weekly 4   --keep-monthly 3   --keep-yearly 1
Глобальная конфигурация vzdump
# /etc/vzdump.conf
storage: my-pbs
mode: snapshot
compress: zstd
bwlimit: 0
ionice: 7
lockwait: 3
stopwait: 10
tmpdir: /var/tmpТипичные ошибки vzdump и их причины
При регулярных бэкапах время от времени встречаются одни и те же ошибки — разберём три самых частых и как их отличить друг от друга. Все три видны в выводе задачи бэкапа в веб-интерфейсе (Datacenter → Tasks) или в журнале /var/log/vzdump/, поэтому первый шаг диагностики — читать точный текст ошибки, а не только код возврата задачи.
VM 100 qmp command 'guest-fsfreeze-freeze' failed - got timeout
ERROR: Backup of VM 100 failed - unable to open file '/var/tmp/vzdumptmp1024_100.tmp' - No space left on device
INFO: skipping vzdump.lock: unable to acquire lock - got timeout after 3 seconds- guest-fsfreeze-freeze failed: qemu-guest-agent не отвечает или не установлен внутри VM — режим suspend не может заморозить файловую систему. Установите агент и включите его в настройках VM:
qm set 100 --agent 1. - No space left on device: временный каталог (по умолчанию /var/tmp) заполнен. Укажите отдельный
tmpdirв /etc/vzdump.conf с достаточным местом. - unable to acquire lock: предыдущее задание бэкапа этой же VM ещё выполняется. Проверьте активные задачи через
pvesh get /nodes/pve/tasksи дождитесь завершения либо снимите зависший lock вручную.
На практике эти три ошибки повторяются волнами: после обновления Proxmox, после переноса каталога временных файлов на другой раздел или после добавления новой крупной VM в общее расписание — стоит перепроверять именно эти места в первую очередь.
Когда vzdump не подходит
Встроенный инструмент закрывает большинство сценариев, но есть случаи, где нужен другой подход — понимание границ применимости экономит время на разборе проблем, которые vzdump в принципе не решает.
- Базы данных с высокой транзакционной нагрузкой: режим snapshot не гарантирует консистентность на уровне приложения — перед бэкапом запускайте штатный дамп СУБД (pg_dump, mysqldump).
- Требование RPO в единицы минут: vzdump — это полнообъёмное копирование по расписанию, а не непрерывная репликация; для минутного RPO нужна ZFS-репликация между нодами.
- Очень большие VM на медленном канале до PBS: первый полный бэкап может занимать часы — планируйте окно обслуживания заранее.
Проверка результата бэкапа
Успешный лог ещё не значит, что бэкап пригоден для восстановления — проверяйте отдельно.
# Статус последних задач бэкапа
pvesh get /nodes/pve/tasks --typefilter vzdump --limit 5

# Список точек восстановления в PBS
proxmox-backup-client snapshot list --repository pbs:backup-store

# Пробное восстановление во временный VM ID
qmrestore pbs:backup/vm/100/2025-03-15T01:00:00Z 999 --storage local-lvm
qm destroy 999 --purge
Если тестовое восстановление проходит без ошибок и VM 999 стартует — бэкап рабочий; такую проверку стоит гонять раз в месяц на реальных бэкапах, а не полагаться только на зелёный статус задачи в интерфейсе. Подробнее о восстановлении — в статье восстановление VM из бэкапа.